Text-to-SQL 已死?AI 不该替你写 SQL
AI 问数最危险的不是报错,而是一个看起来对的错数。我们梳理了学界评测、开发者社区和 dbt、Snowflake 的公开数据,聊聊 Text-to-SQL 为什么不适合不写 SQL 的人,以及数力AI 为什么让 AI 搭积木、不写查询。
· 阅读约 8 分钟
你把订单表交给一个 AI 问数工具,问它:「上个月各品类的客单价是多少?」几秒钟后,它给你一张表,数字整齐,格式漂亮。你顺手贴进了周报。
问题是,它算错了。客单价应该是「销售额 ÷ 订单数」,而一张订单往往有好几行商品明细。AI 写的是 COUNT(订单号),不是 COUNT(DISTINCT 订单号)。分母被放大了好几倍,客单价被压低了一大截。
-- AI 写的
SUM(金额) / COUNT(订单号)

-- 应该是
SUM(金额) / COUNT(DISTINCT 订单号)除非你会读 SQL,并且恰好去读了,否则你永远不会知道。这不是个例,而是 Text-to-SQL(也叫 NL2SQL,让 AI 把自然语言翻译成 SQL)这条路线最根本的问题。
这篇文章聊三件事:学界和开发者社区到底怎么评价 Text-to-SQL;行业正在往哪个方向走;以及我们在做数力时,为什么选择了另一条路。
榜单上 90%,真实世界里 21%
Text-to-SQL 的承诺很诱人:不用学 SQL,开口就能问数。过去两三年,大模型在学术榜单上的成绩也确实亮眼。
但榜单和真实业务是两回事。ICLR 2025 的 Spider 2.0 论文把题目换成了真实企业场景:动辄上百张表、嵌套字段、不同的 SQL 方言。结果如下:
| 测试集 | 场景 | 最好成绩 |
|---|---|---|
| Spider 1.0 | 学术题,表少、定义清楚 | 91.2% |
| BIRD | 更接近真实数据的学术题 | 73.0% |
| Spider 2.0 | 632 个真实企业数据任务 | 21.3%(o1-preview + 智能体框架) |
模型在进步,这个数字也在涨。但问题没有消失:越接近真实业务,准确率越低。
开发者社区的评价更直白。Hacker News 上一场题为「Text-to-SQL is dead, long live text-to-SQL」的讨论里,有人说它「works just enough to be dangerous」,刚好好用到足以危险。另一场讨论里的观点更有代表性:难的从来不是语法,而是搞清楚数据本身是什么意思。
也有人替它辩护:对本来就懂数据模型、能读懂 SQL 的人来说,Text-to-SQL 是实打实的提效工具。这一点我们完全同意,后文还会回到它。
问题不在模型,在于让它写什么
很多人觉得,模型再强一点,问题就解决了。我们不这么看。Text-to-SQL 有三个结构性的问题,模型变强只能缓解,消除不了。
一、错误是沉默的。 SQL 写错通常不会报错,只会返回一个错的数。JOIN 多关联一次,销售额就被重复计算;COUNT 少写一个 DISTINCT,客单价就偏了。错的答案和对的答案长得一模一样。
二、模型不懂你的业务。 「收入」是含税还是不含税?「订单」算不算已退款的?「上个月」按下单日还是按发货日?这些答案不在字段名里,模型只能猜。每次提问都重新猜一遍,同一个指标问两次,可能得到两个口径。
三、结果没法审。 这是我们认为最关键的一点。要确认 AI 算得对不对,你得读懂它写的 SQL。可 Text-to-SQL 的卖点恰恰是「不会 SQL 也能用」。让不会 SQL 的人去审查 SQL,这本身就是个矛盾。
想改一个条件也是同样的困境。「把退款订单去掉」「改成按季度看」:要么重新问一遍,让 AI 重写一条新的 SQL,于是又要重新信任一遍;要么自己在一段几十行的 SQL 里找到那个 WHERE,小心地改。对大多数业务人员来说,这两条路都不现实。
行业的答案:在中间加一层
主流厂商已经用行动给了答案:不再让模型从零写 SQL,而是在自然语言和 SQL 之间加一层结构化的「语义层」。指标怎么算、口径是什么,由人事先定义好;模型只负责从这些定义里挑选和组合,SQL 由程序确定性地生成。
| 方案 | 做法 | 公开的数据 |
|---|---|---|
| dbt Labs(2026 年 4 月) | 同一组问题,对比直接写 SQL 和走语义层 | Claude Sonnet 4.6:90.0% → 98.2%;GPT-5.3 Codex:84.1% → 100% |
| Snowflake Cortex Analyst(2024 年 8 月) | 基于语义模型生成 SQL | 真实场景 90% 以上;单用 GPT-4o 直接写 SQL:51% |
| 国内 ChatBI(NL2DSL2SQL) | 先生成 DSL,再由程序转成 SQL | 直接 NL2SQL 通常 60%–70%;NL2DSL2SQL 70%–87% |
数字之外,dbt 的报告里有一句话最值得记住:语义层答不了的时候,它会报错;Text-to-SQL 答错的时候,它给你一个看起来很合理的错数。 前者可以补救,后者会被贴进周报。
所以与其说 Text-to-SQL 死了,不如说它被「降级」了。dbt 自己的结论也是两者并用:周报、KPI、要给老板看的数字走语义层;临时探索、一次性的问题,由懂 SQL 的分析师用 Text-to-SQL 加速。让不懂 SQL 的人直接信任 AI 写的 SQL,这条路确实走不通。
数力的做法:让 AI 搭积木,而不是写代码
数力是一个桌面端的数据分析工具,核心是透视表、度量和图表。做数力AI 时,我们给自己定了一条规矩:AI 能做的操作,就是人在界面上能做的操作。
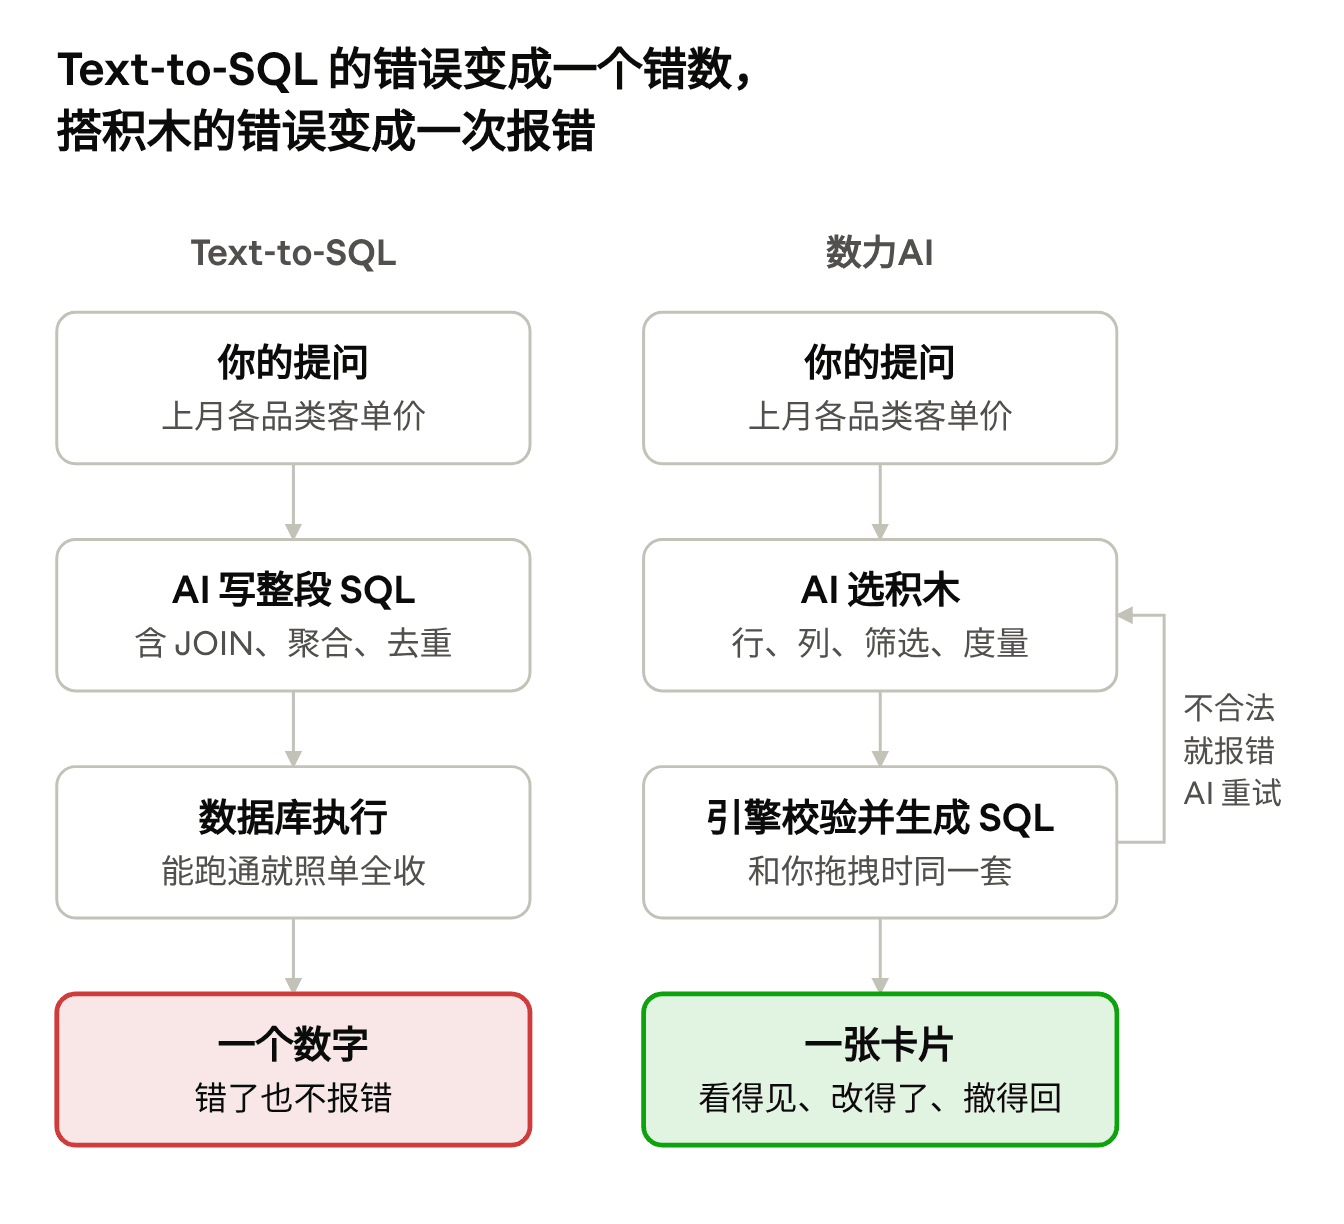
它不写查询语句。它做的是和你一样的事:
- 把「品类」放到行,把「月份」放到列,加一个筛选「订单状态 ≠ 已退款」
- 定义一个度量:选一个字段和一种聚合(求和、平均、计数、去重计数……),或者把度量加减乘除,比如「客单价 = 销售额 ÷ 订单数(去重)」
- 选一种图表,写上标题和结论
SQL 由数力的引擎根据这些积木生成,和你自己拖拽生成的完全是同一套代码。
一、更不容易错
一整类错误在结构上就不会发生:GROUP BY 写漏字段、聚合层级对不上、小计重复计算、方言语法写错。这些都由引擎负责,而引擎是经过测试的确定性代码。开头那个客单价的例子里,「去重计数」是一个明确的选项,而不是藏在括号里的一个关键字。
AI 如果要了一个不存在的字段、一种不支持的聚合,引擎会直接拒绝,并把原因告诉 AI,AI 修正后重试。这就是 dbt 那句话的落地:错了就报错,而不是吐出一个合理的错数。度量定义一次、整份报告共用,口径也不会每问一次变一次。
二、随时可以接手
AI 的每一步都是一张卡片:一张透视表或一张图。它用了哪些字段、加了什么筛选、度量怎么定义的,全都摆在界面上,和你自己做的卡片一模一样。
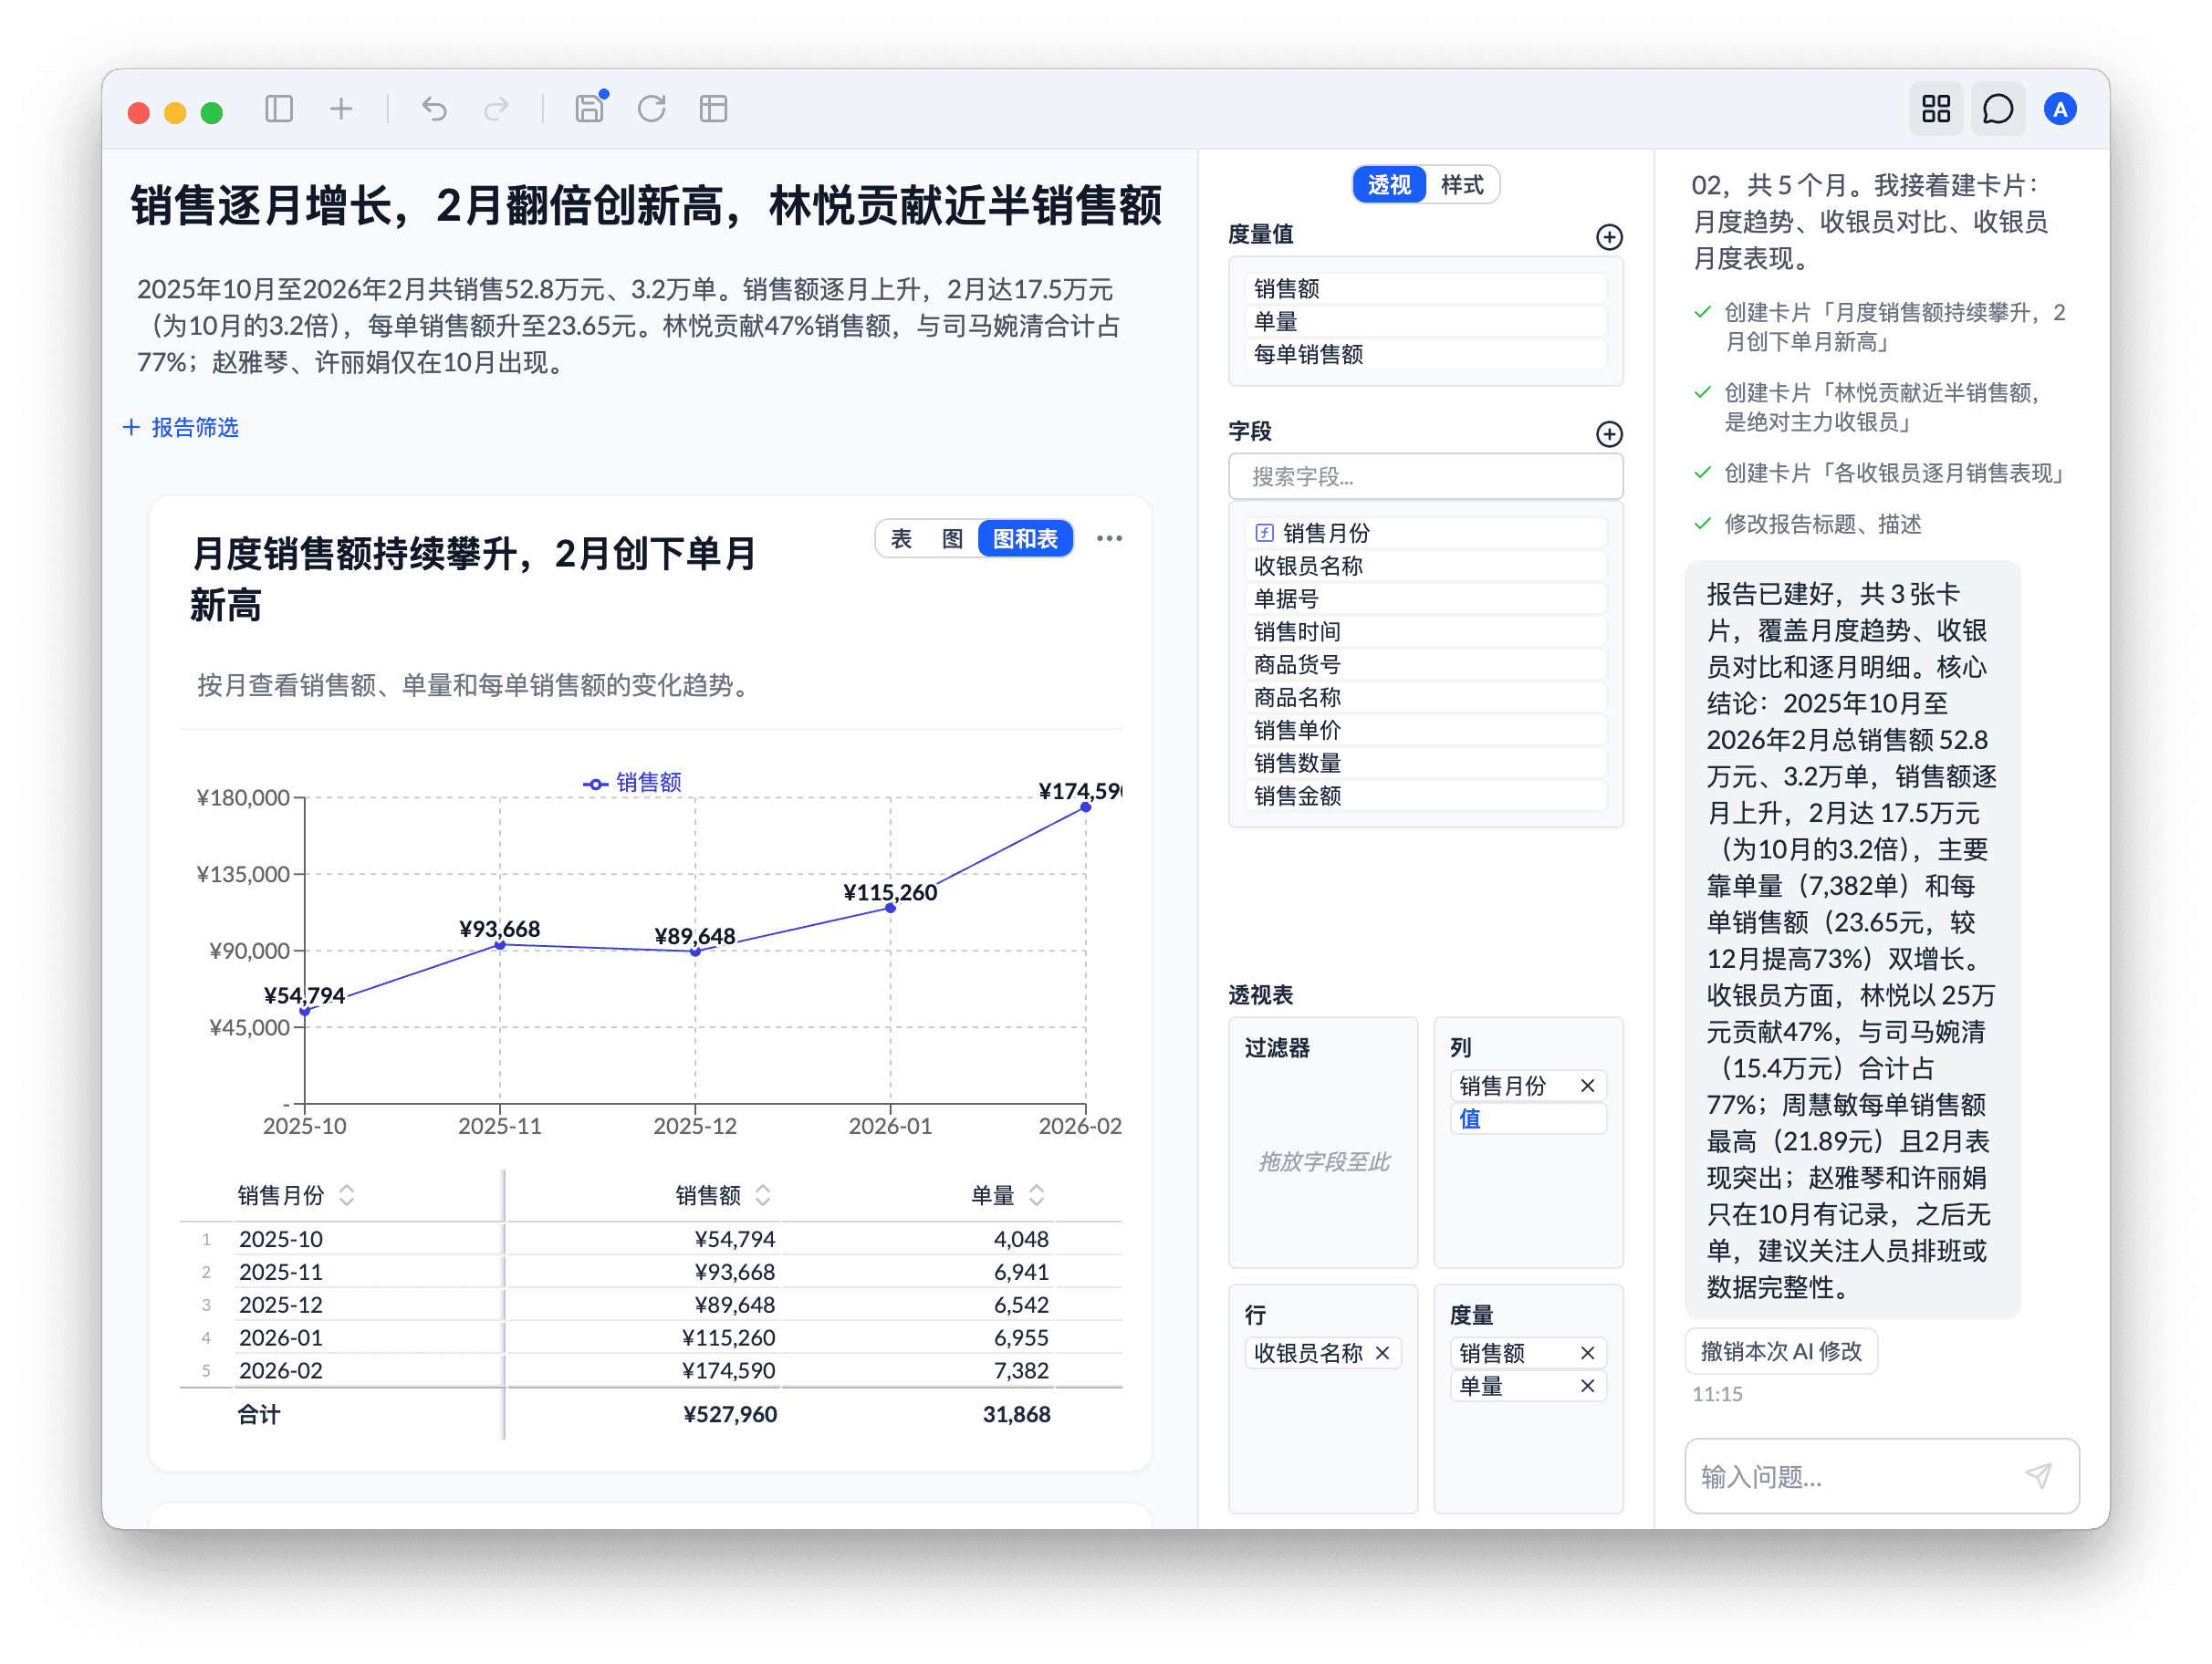
想把退款订单去掉?点开筛选改一下。想按季度看?把「月份」换成「季度」。不满意 AI 的某一步?一键撤销。不需要读懂任何代码,也不需要重新问一遍。
完全不碰代码吗?也不是。遇到「从货号里拆出品类」这样的需求,AI 会建一个计算列,写一行表达式,比如 split_part(商品货号, '-', 1)。但它只作用于一行数据,写错会实时报错,并且就摆在计算列编辑器里,你看得见、改得了。一行表达式和一段几十行的查询,审起来完全不是一个量级。
代价:搭积木做不到什么
公平地说,这个取舍是有代价的。积木的种类有限,就意味着有些问题拼不出来:
- 多表 JOIN:数力一次分析一张表,目前只读 CSV,不直连数据库
- 任意查询:子查询、复杂的窗口函数、多步计算
- 数据清洗和建模:这些还是应该在数据库里用 SQL 做好
我们认为这个代价值得。日常经营里的绝大多数问题,都是「分组 + 聚合 + 筛选 + 对比」:哪个品类卖得好、哪个月下滑了、谁的退款率偏高。这些问题用透视表都能表达,而且做出来的东西业务人员自己看得懂、改得动。
至于那些真正需要任意 SQL 的问题,它们本来就属于会写 SQL 的人。对他们来说,Text-to-SQL 是很好的助手,因为他们能读懂、能审查。一个常见的分工是:在数据库里用 SQL 取数、JOIN、清洗,导出成 CSV,再交给透视表和 AI 去分析、出图、写报告。数力 vs SQL 里有这套分工的具体做法。
结论:Text-to-SQL 没死,只是用错了地方
Text-to-SQL 不会消失。对懂 SQL 的人,它是很好的加速器。
但对不写 SQL 的业务人员,让 AI 直接写 SQL、再让人盲信结果,是一个结构性的错误。行业已经在用语义层修正它,数力走得更远一点:AI 操作的就是用户自己的透视表,每一步都看得见、改得了、撤得回。
我们相信,AI 数据分析的下一步,不是更聪明的 SQL 生成器,而是会用工具的 AI:用的是和人一样的工具,留下的是人能接手的成果。
想试试?数力可以免费下载,支持 Windows 和 Mac(Apple 芯片)。数力AI 免费使用,无需注册。导入、计算都在你的电脑上完成;只有当你主动使用数力AI 时,才会把完成分析所需的最少信息发给模型服务商:字段名、汇总结果,必要时还有少量明细样本(每次最多 20 行,界面上会提示)。
参考资料
- Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows,ICLR 2025
- Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update,dbt Labs,2026 年 4 月
- Snowflake Cortex Analyst: Evaluating Text-to-SQL Accuracy for Real-World BI,Snowflake,2024 年 8 月
- NL2DSL2SQL 是实现 ChatBI 的正确技术路线吗?,腾讯云开发者社区
- Text-to-SQL is dead, long live text-to-SQL,Hacker News 讨论
- 「The hard part is not syntax」,Hacker News 评论,2024 年 2 月